欢迎来到老苏的AI茶馆,一杯茶,一段话,聊聊 AI 的那些事儿。
1、什么是AGENTS.md
AGENTS.md是一种简单、开放的编码代理指导格式,简单来讲,可以将 AGENTS.md 视为Agent的 README:一个专门的、可预测的地方,用于提供上下文和说明,以帮助 AI 编码代理在您的项目中工作。
AGENTS.md 是人工智能软件开发生态系统中各方共同努力的成果,其中包括 OpenAI Codex、Amp、Google 的 Jules、Cursor 和 Factory。
1-1、为什么使用AGENTS.md
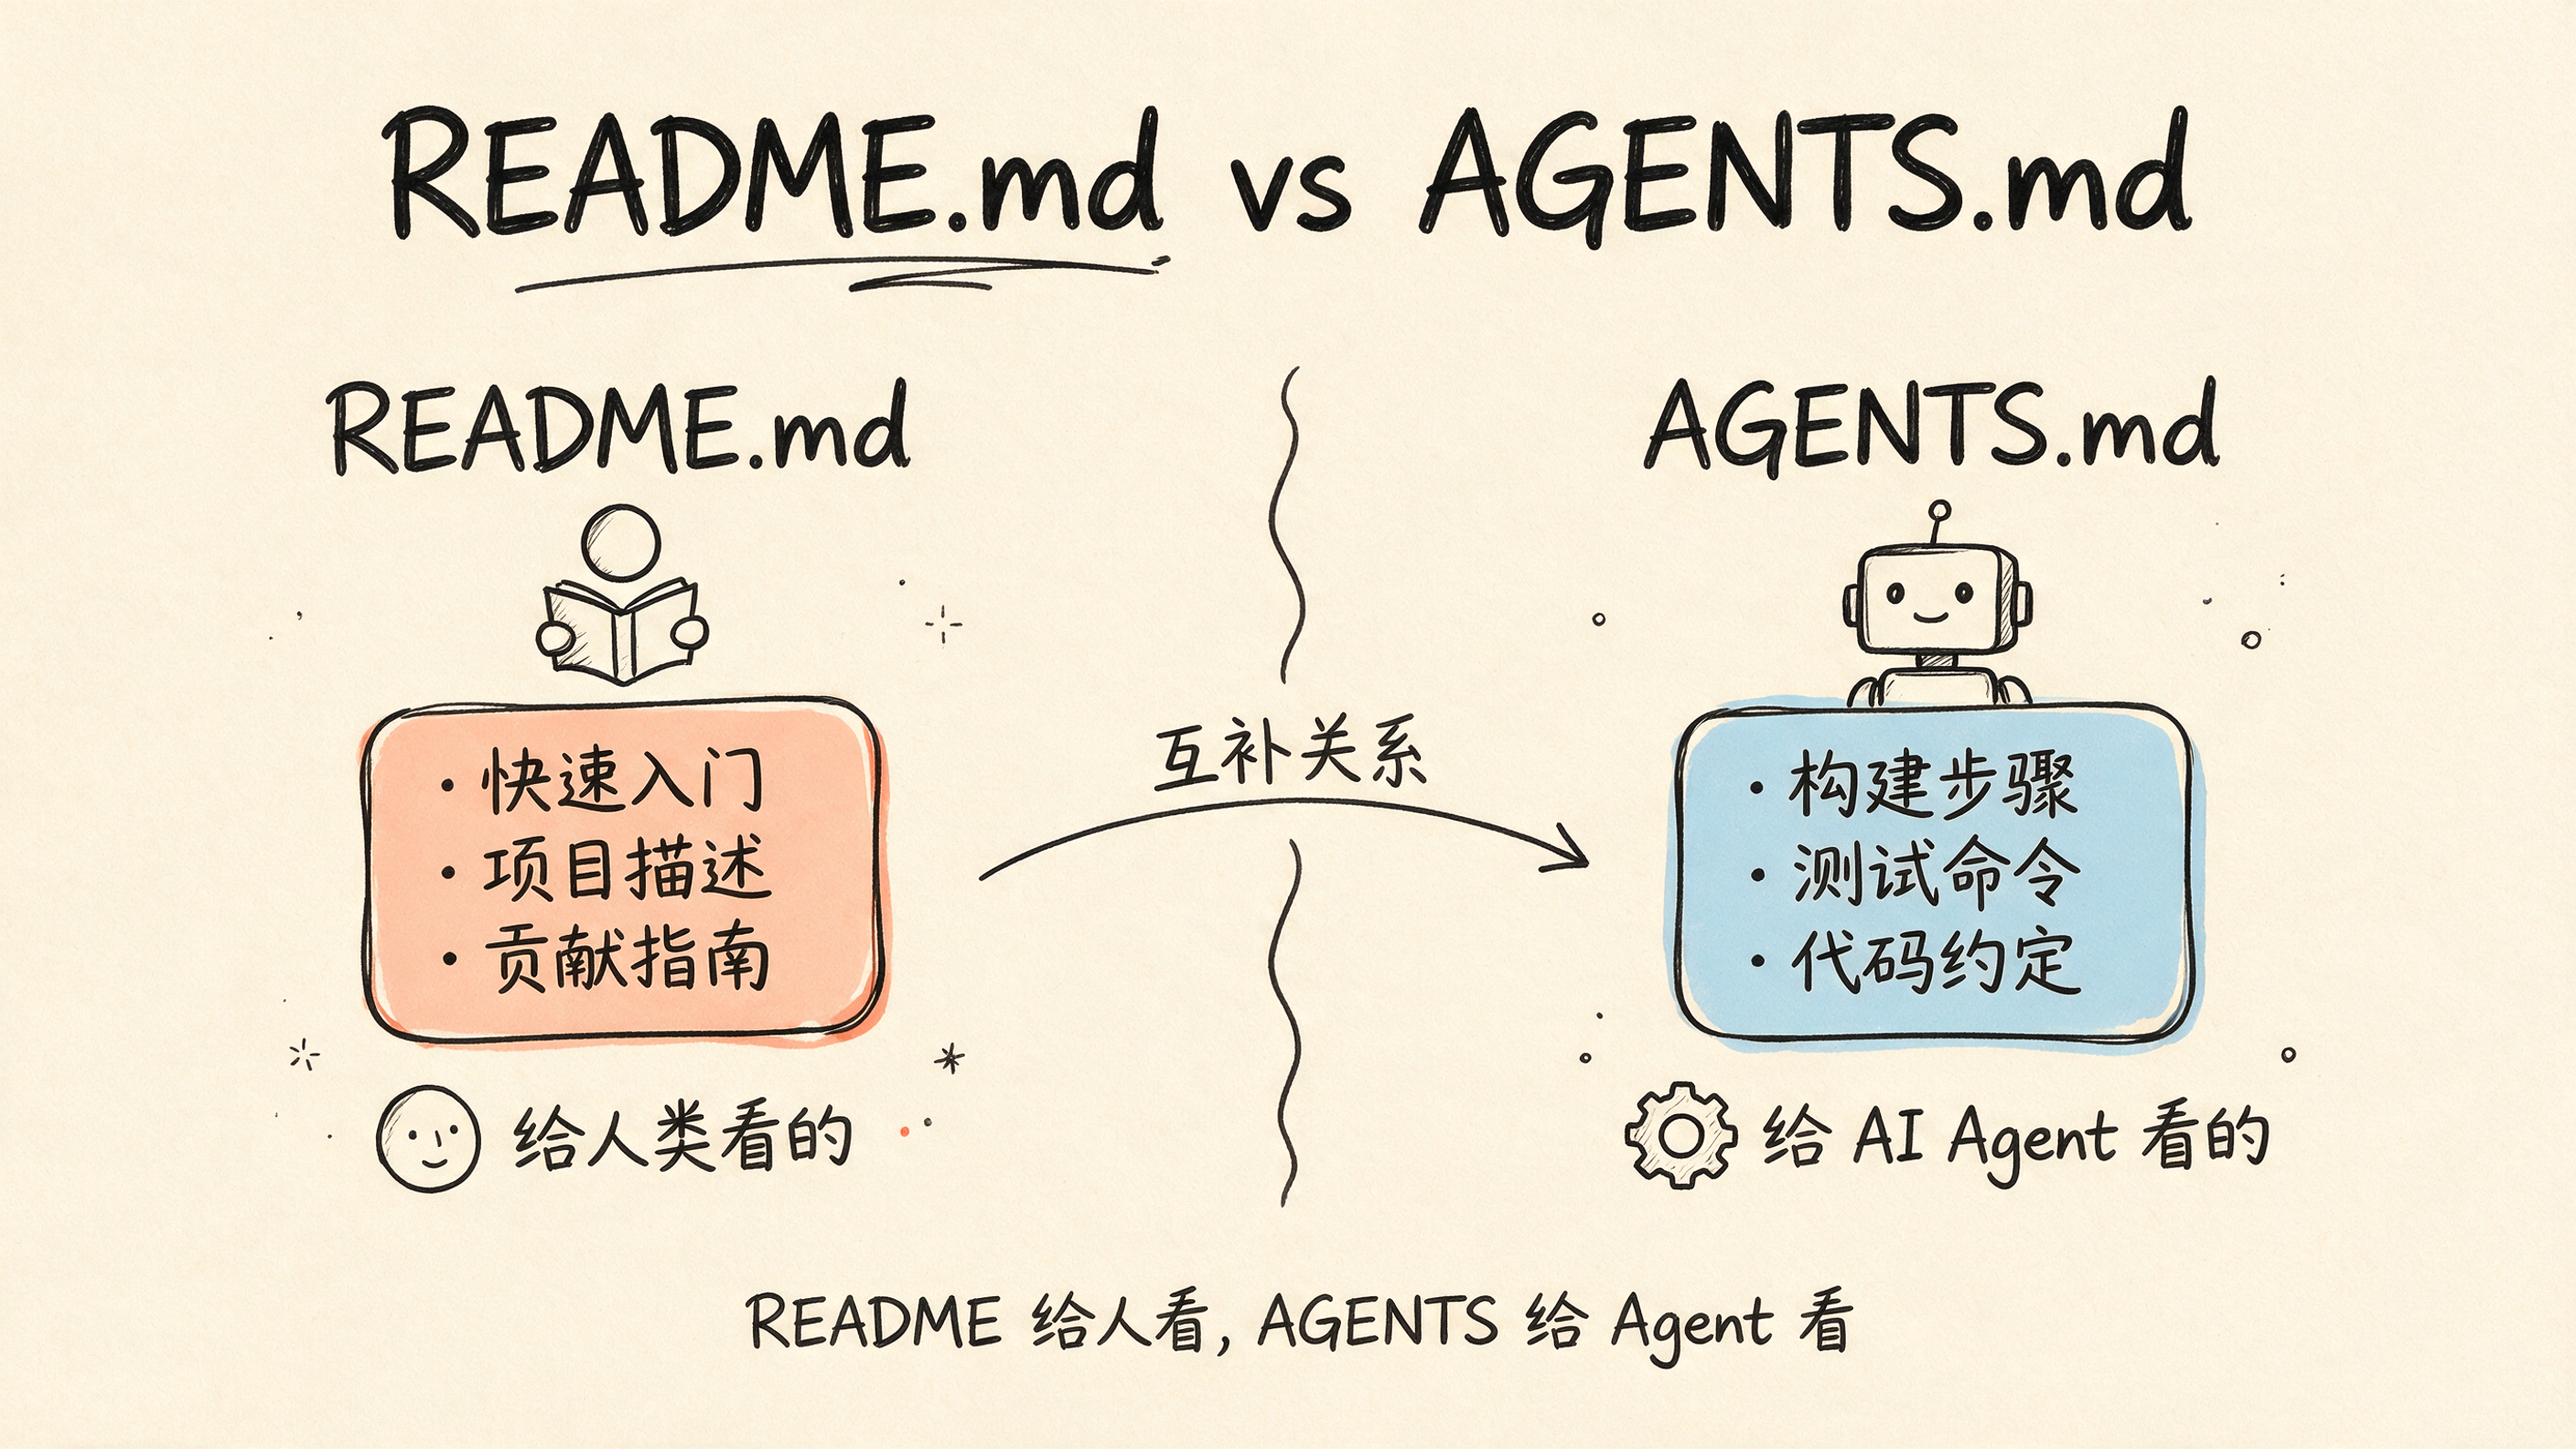
README.md 文件是为人类准备的:快速入门指南、项目描述和贡献指南。
AGENTS.md 对此进行了补充,其中包含编码代理所需的额外、有时详细的上下文:构建步骤、测试和约定,这些内容可能会使 README 变得杂乱,或者与人类贡献者无关。
一句话总结:README.md是给人类看的,AGENTS.md是给AGENTS看的
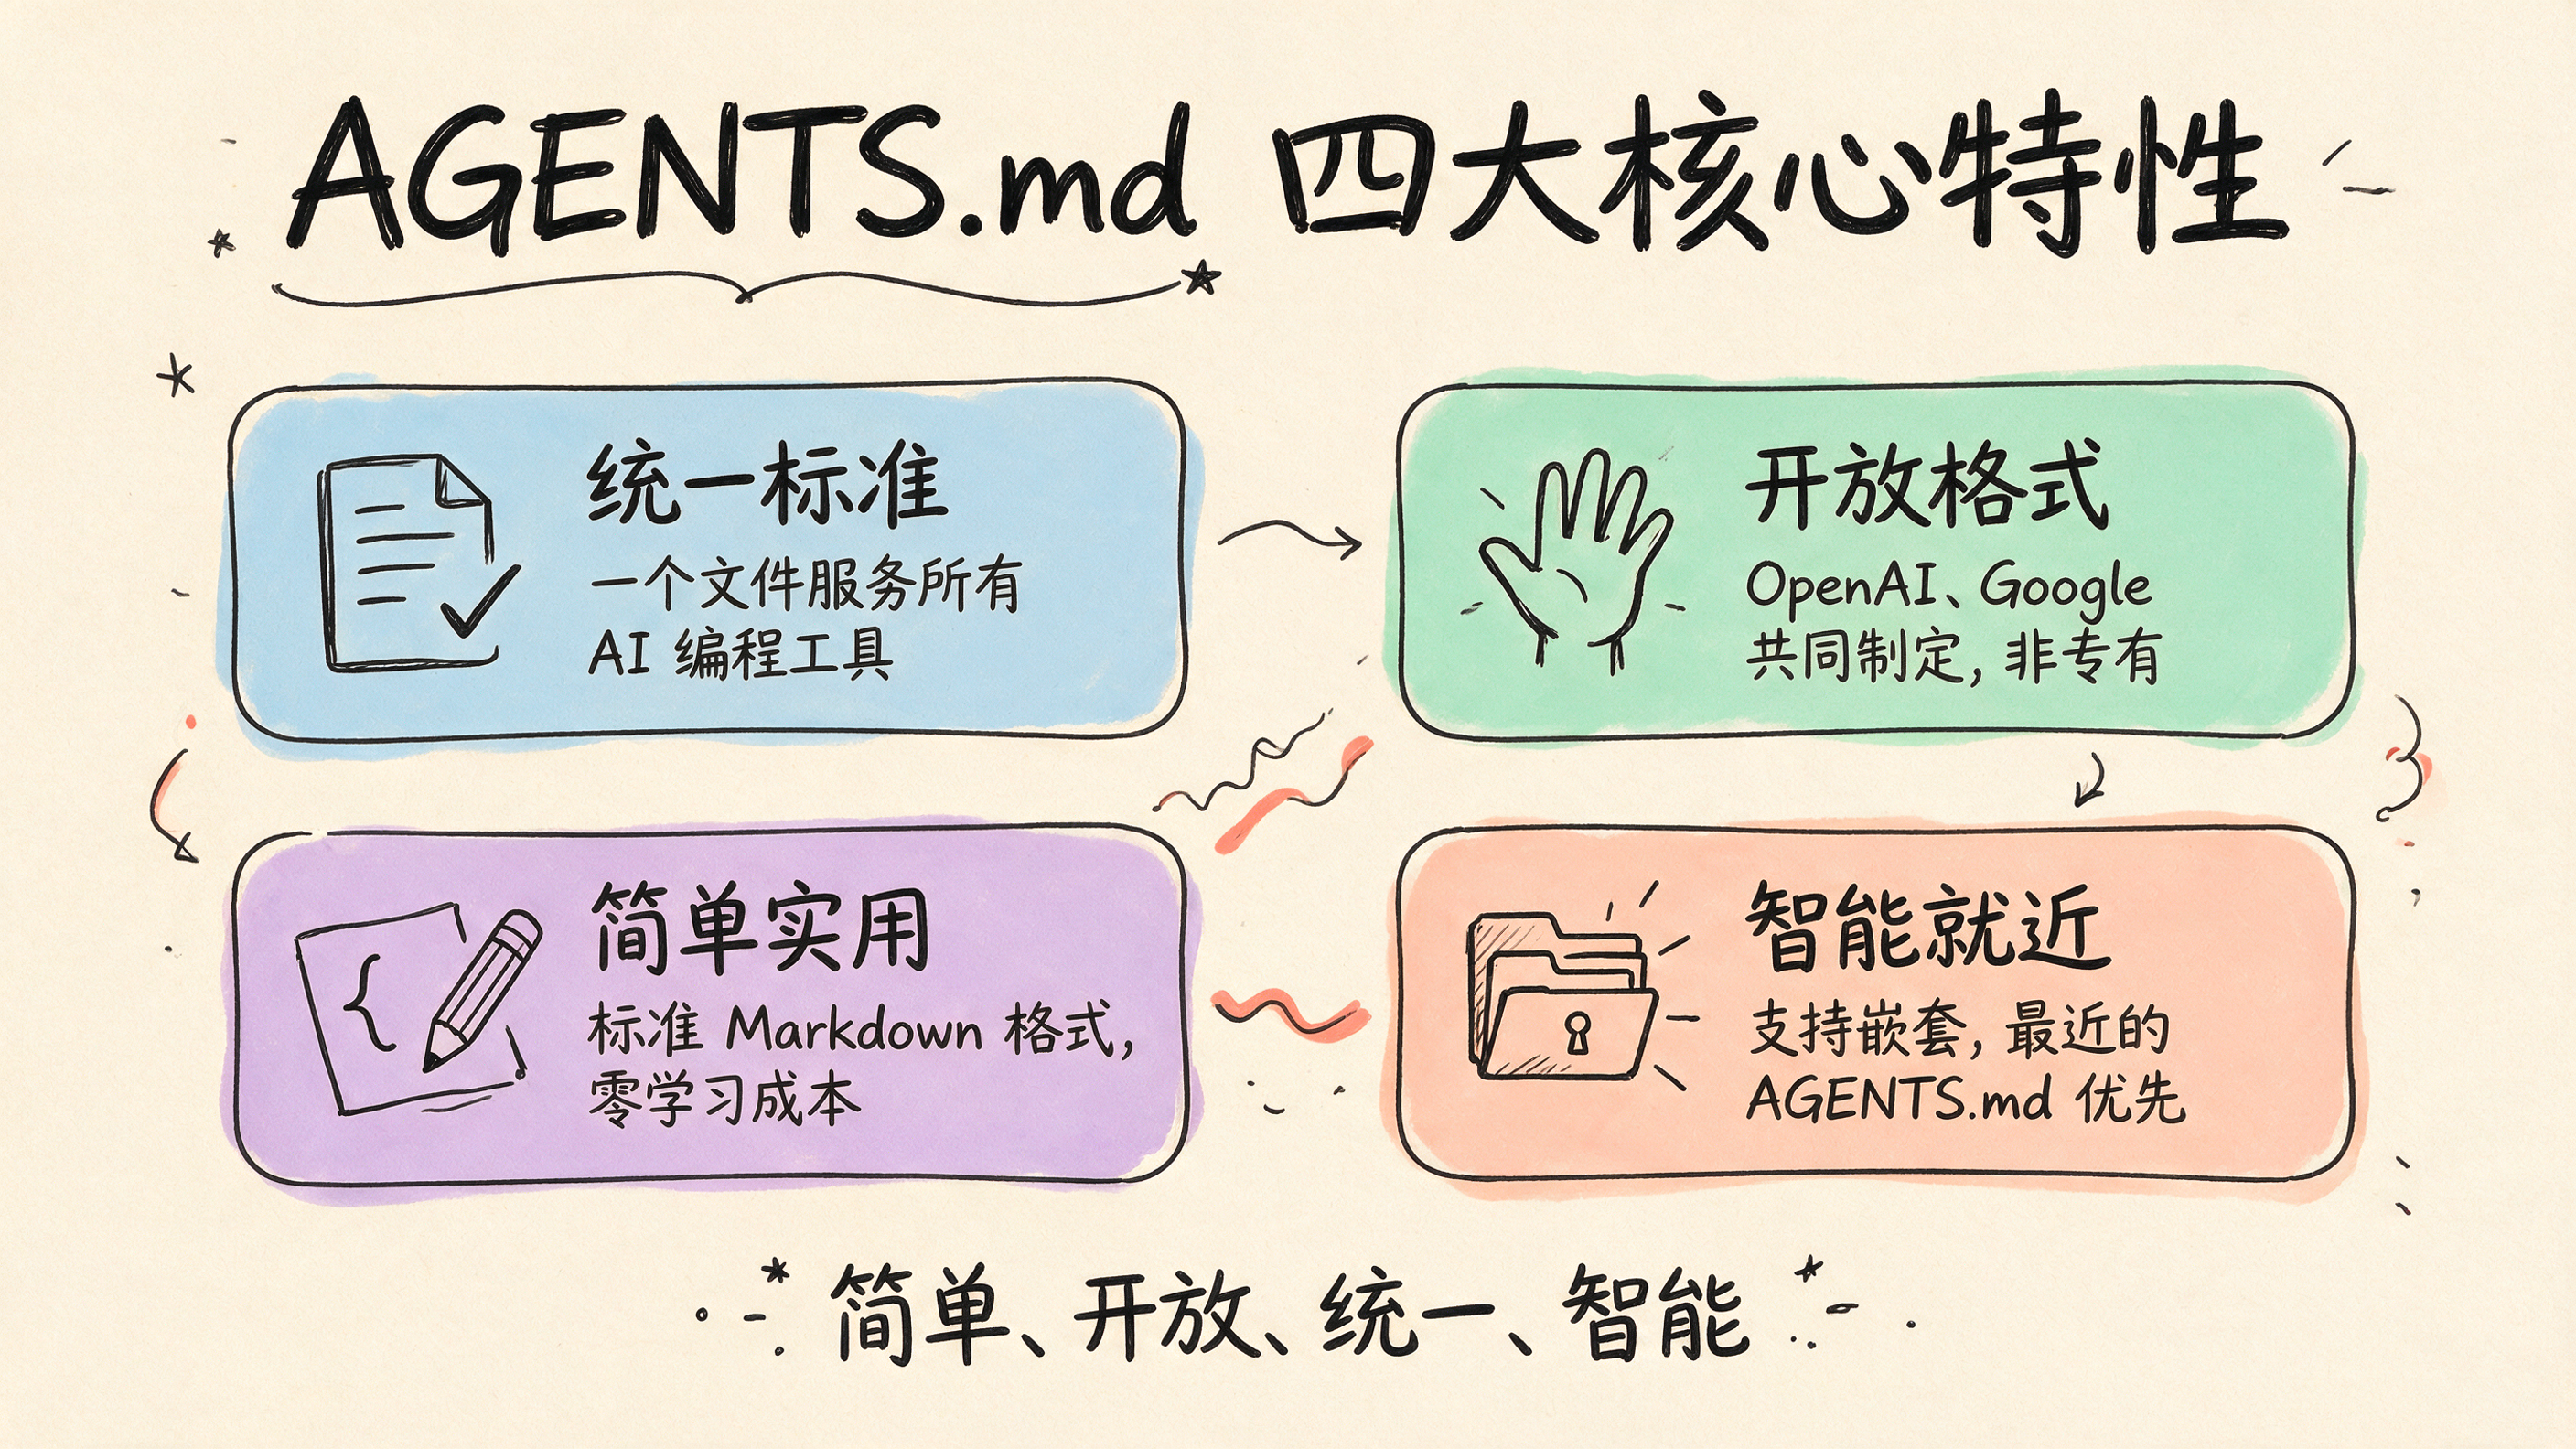
AGENTS.md的核心思想,可以用以下几句话进行总结
- 统一标准:一个文件服务所有 AI 编程工具
- 开放格式:由 OpenAI、Google 等共同制定,非专有
- 简单实用:标准 Markdown 格式,零学习成本
- 智能就近:支持嵌套,离文件最近的 AGENTS.md 优先
2、创建AGENTS文件
只需在需要的目录中创建一个名为 AGENTS.md 或 agents.md 的文件即可。该文件使用普通 Markdown 格式,不需要任何特殊的 frontmatter。
AGENTS.md示例结构
my-project/
├── AGENTS.md                    # 整个项目的全局指令
├── frontend/
│   ├── AGENTS.md                # 前端代码专用指令
│   └── src/
│       └── components/
│           └── AGENTS.md        # 组件专用指令
├── backend/
│   └── AGENTS.md                # 后端代码专用指令
└── docs/
    └── AGENTS.md                # 文档指令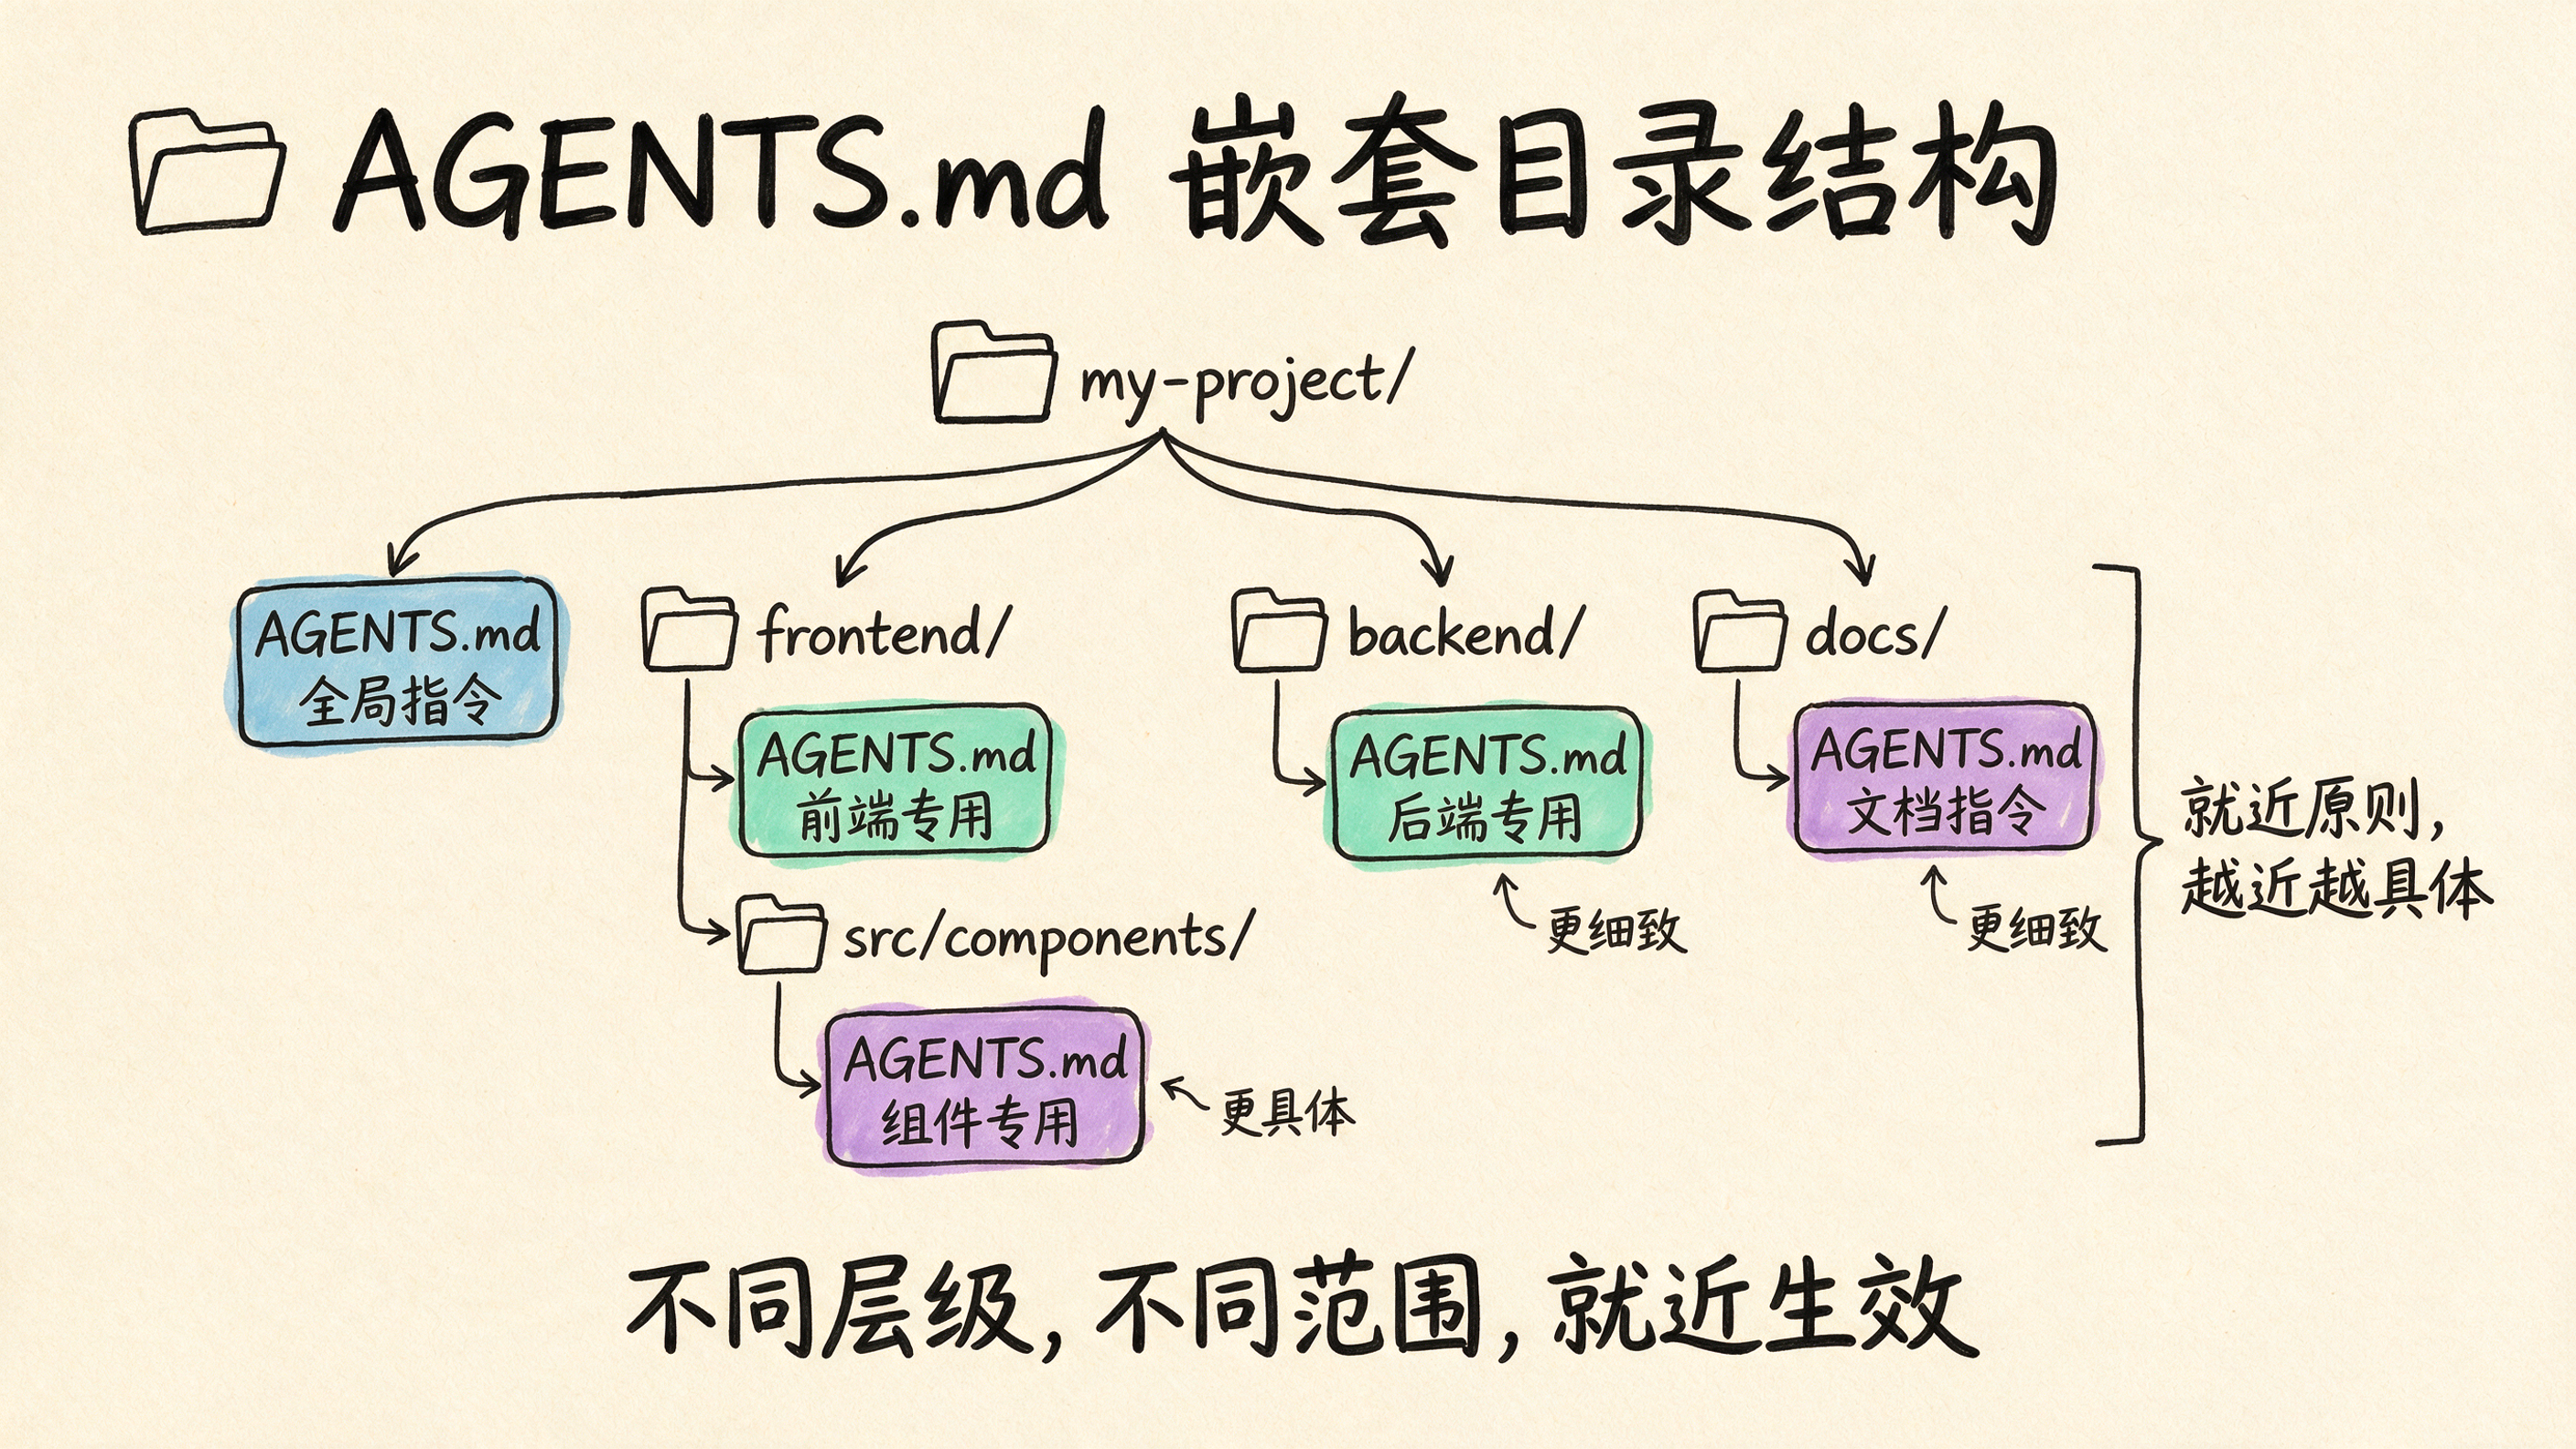
示例文件
# Sample AGENTS.md file

## Dev environment tips
- Use `pnpm dlx turbo run where <project_name>` to jump to a package instead of scanning with `ls`.
- Run `pnpm install --filter <project_name>` to add the package to your workspace so Vite, ESLint, and TypeScript can see it.
- Use `pnpm create vite@latest <project_name> -- --template react-ts` to spin up a new React + Vite package with TypeScript checks ready.
- Check the name field inside each package's package.json to confirm the right name—skip the top-level one.

## Testing instructions
- Find the CI plan in the .github/workflows folder.
- Run `pnpm turbo run test --filter <project_name>` to run every check defined for that package.
- From the package root you can just call `pnpm test`. The commit should pass all tests before you merge.
- To focus on one step, add the Vitest pattern: `pnpm vitest run -t "<test name>"`.
- Fix any test or type errors until the whole suite is green.
- After moving files or changing imports, run `pnpm lint --filter <project_name>` to be sure ESLint and TypeScript rules still pass.
- Add or update tests for the code you change, even if nobody asked.

## PR instructions
- Title format: [<project_name>] <Title>
- Always run `pnpm lint` and `pnpm test` before committing.
3、加载顺序
AGENTS.md 的一大优势是可以根据文件位置自动确定作用域
这意味着你可以在不同层级放置多个 AGENTS.md 文件,每个文件为其所在目录提供更细致、更加具体的指导。
TRAE AGENTS的核心加载逻辑
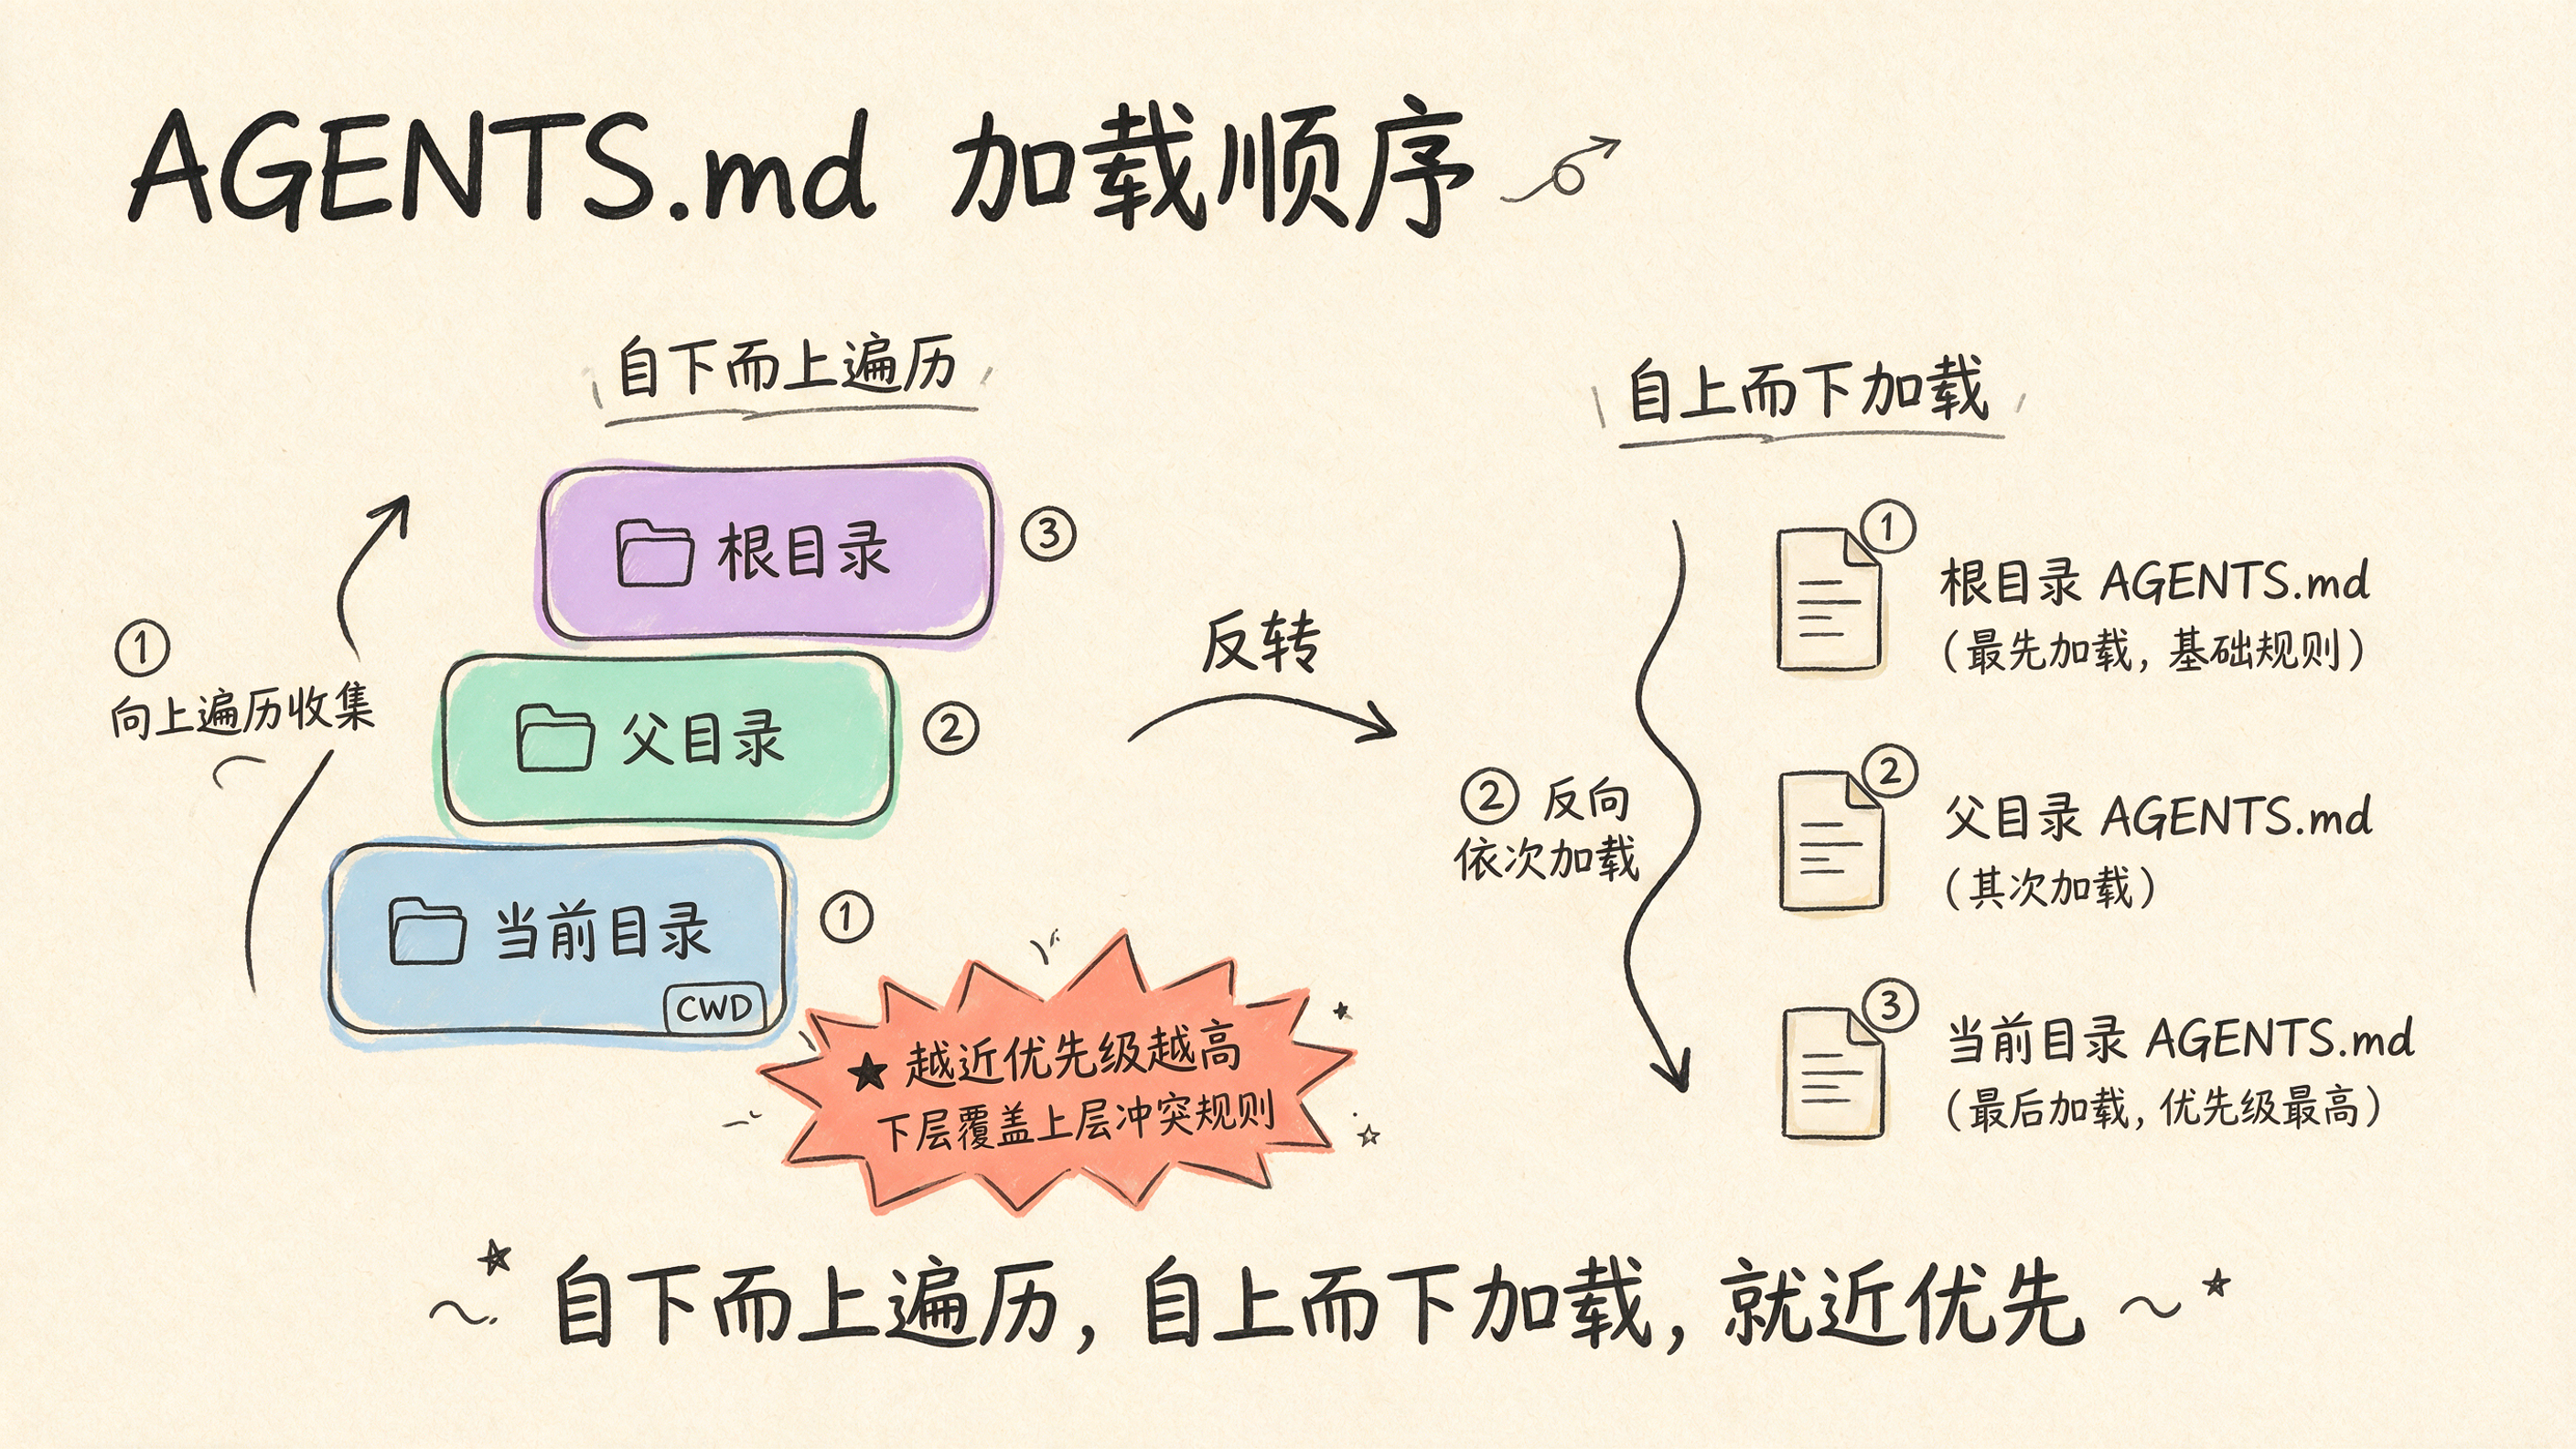
从当前工作目录开始 向上递归遍历 ,加载所有能覆盖当前目录的 AGENTS.md,形成从子到父的规则继承链,并非一次性加载所有子目录下的文件,只有进入对应子目录工作时,才会加载该子目录的 AGENTS.md,且仅对当前子目录及其下属文件生效
越靠近当前工作目录的 AGENTS.md 优先级越高,下层文件的规则会覆盖上层文件的冲突规则
CLAUDE的CLAUDE.md的加载逻辑是
不同级别的CLAUDE.md 与 Auto memory 的整体加载顺序,应如下
1. Managed Memory    (/etc/claude-code/CLAUDE.md)     - 全局管理指令
  1. User Memory       (~/.claude/CLAUDE.md)            - 用户级别的全局指令
  2. Project Memory    (从根目录到当前工作目录(CWD),自下而上遍历,自上而下加载)
     ├── CLAUDE.md     (项目根目录中的)
     ├── .claude/CLAUDE.md
     └── .claude/rules/*.md (按字母顺序)
  3. Local Memory      (CLAUDE.local.md,也在项目中)        - 项目本地指令

  4. Auto Memory (源码中的@memdir)  ~/.claude/projects/<project>/memory/MEMORY.md
  5. Team Memory       (共享团队记忆,如启用。)
Project Memory 的加载方式是:自下而上遍历,自上而下加载
// 先从当前目录自下而上遍历收集所有目录的CLAUDE.md,直到根目录
  while (currentDir !== parse(currentDir).root) {
    dirs.push(currentDir)
    currentDir = dirname(currentDir)
  }

  // 然后反转后再自上而下加载,从根目录向下依次加载CLAUDE.md
  for (const dir of dirs.reverse()) {
    // 加载 CLAUDE.md, .claude/CLAUDE.md, .claude/rules/*.md
  }
4、如何写好一个AGENTS.md
AGENTS里面主要放哪些内容
AGENTS的示例
# MyApp — 电商管理后台

基于 Next.js 14 App Router + Prisma + PostgreSQL 的电商管理系统。

## 技术栈
- 前端:Next.js 14(App Router)、TypeScript、Tailwind CSS、shadcn/ui
- 后端:Next.js API Routes、Prisma ORM
- 数据库:PostgreSQL 15
- 认证:NextAuth.js v5
- 包管理:pnpm

## 常用命令


pnpm dev                    # 启动开发服务器(端口 3000)
pnpm build && pnpm start    # 构建并启动生产服务器
pnpm test                   # 运行所有测试
pnpm test:e2e               # 运行端到端测试(需先启动 dev server)
pnpm db:migrate             # 执行数据库迁移
pnpm db:studio              # 打开 Prisma Studio(数据库可视化工具)
pnpm lint && pnpm typecheck # 代码检查和类型检查


## 项目结构

- `src/app/` — App Router 页面和 API 路由
- `src/app/(dashboard)/` — 需要登录的后台页面
- `src/app/api/` — API 路由(RESTful 风格)
- `src/components/` — 可复用组件
- `src/lib/` — 工具函数、数据库客户端、认证配置
- `prisma/schema.prisma` — 数据库 Schema 定义

## 编码规范

- 只使用具名导出(named export),禁止 default export(除 Next.js 页面文件外)
- 服务端组件默认 async,客户端组件在文件顶部加 `"use client"`
- API 路由统一返回格式:成功 `{ data: T }`,失败 `{ error: string, code: string }`
- 数据库查询封装在 `src/lib/db/` 目录下,不在其他地方直接使用 `prisma` 客户端

## 注意事项

- `prisma/migrations/` 中已有文件**禁止修改**,数据库变更只能执行 `pnpm db:migrate` 新增迁移
- `.env.local` 包含真实密钥,**禁止读取或输出文件内容**
- `src/lib/auth.ts` 是认证核心文件,**修改前必须告知我**
- 修改 `prisma/schema.prisma` 后必须执行 `pnpm db:migrate` 并提交迁移文件
大小的限制
Codex 在项目文档中提到,
https://developers.openai.com/codex/guides/agents-md
project_doc_max_bytes,project级别的大小会限制在32K,超过这个部分的内容会自动截断
所以整体的最好控制在80-150行,建议总字数控制在 500 字以内,超过 1000 字时需要考虑精简
多模块仓库(Monorepo)的配置方式
在 Monorepo 中,可以在仓库根目录放一个全局 CLAUDE.md,每个子包目录下再放各自的 CLAUDE.md。Claude 打开某个子包的文件时,会同时加载根目录和该子包目录下的两个文件
my-monorepo/
├── CLAUDE.md                  ← 全局规范:共用命令、整体架构、通用约定
├── packages/
│   ├── web/
│   │   └── CLAUDE.md          ← 前端专属:React 规范、样式约定、构建流程
│   ├── api/
│   │   └── CLAUDE.md          ← 后端专属:API 设计规范、数据库约定
│   └── shared/
│       └── CLAUDE.md          ← 共享包:导出规则、版本管理约定
└── tools/
    └── CLAUDE.md              ← 工具脚本:特殊说明和使用限制
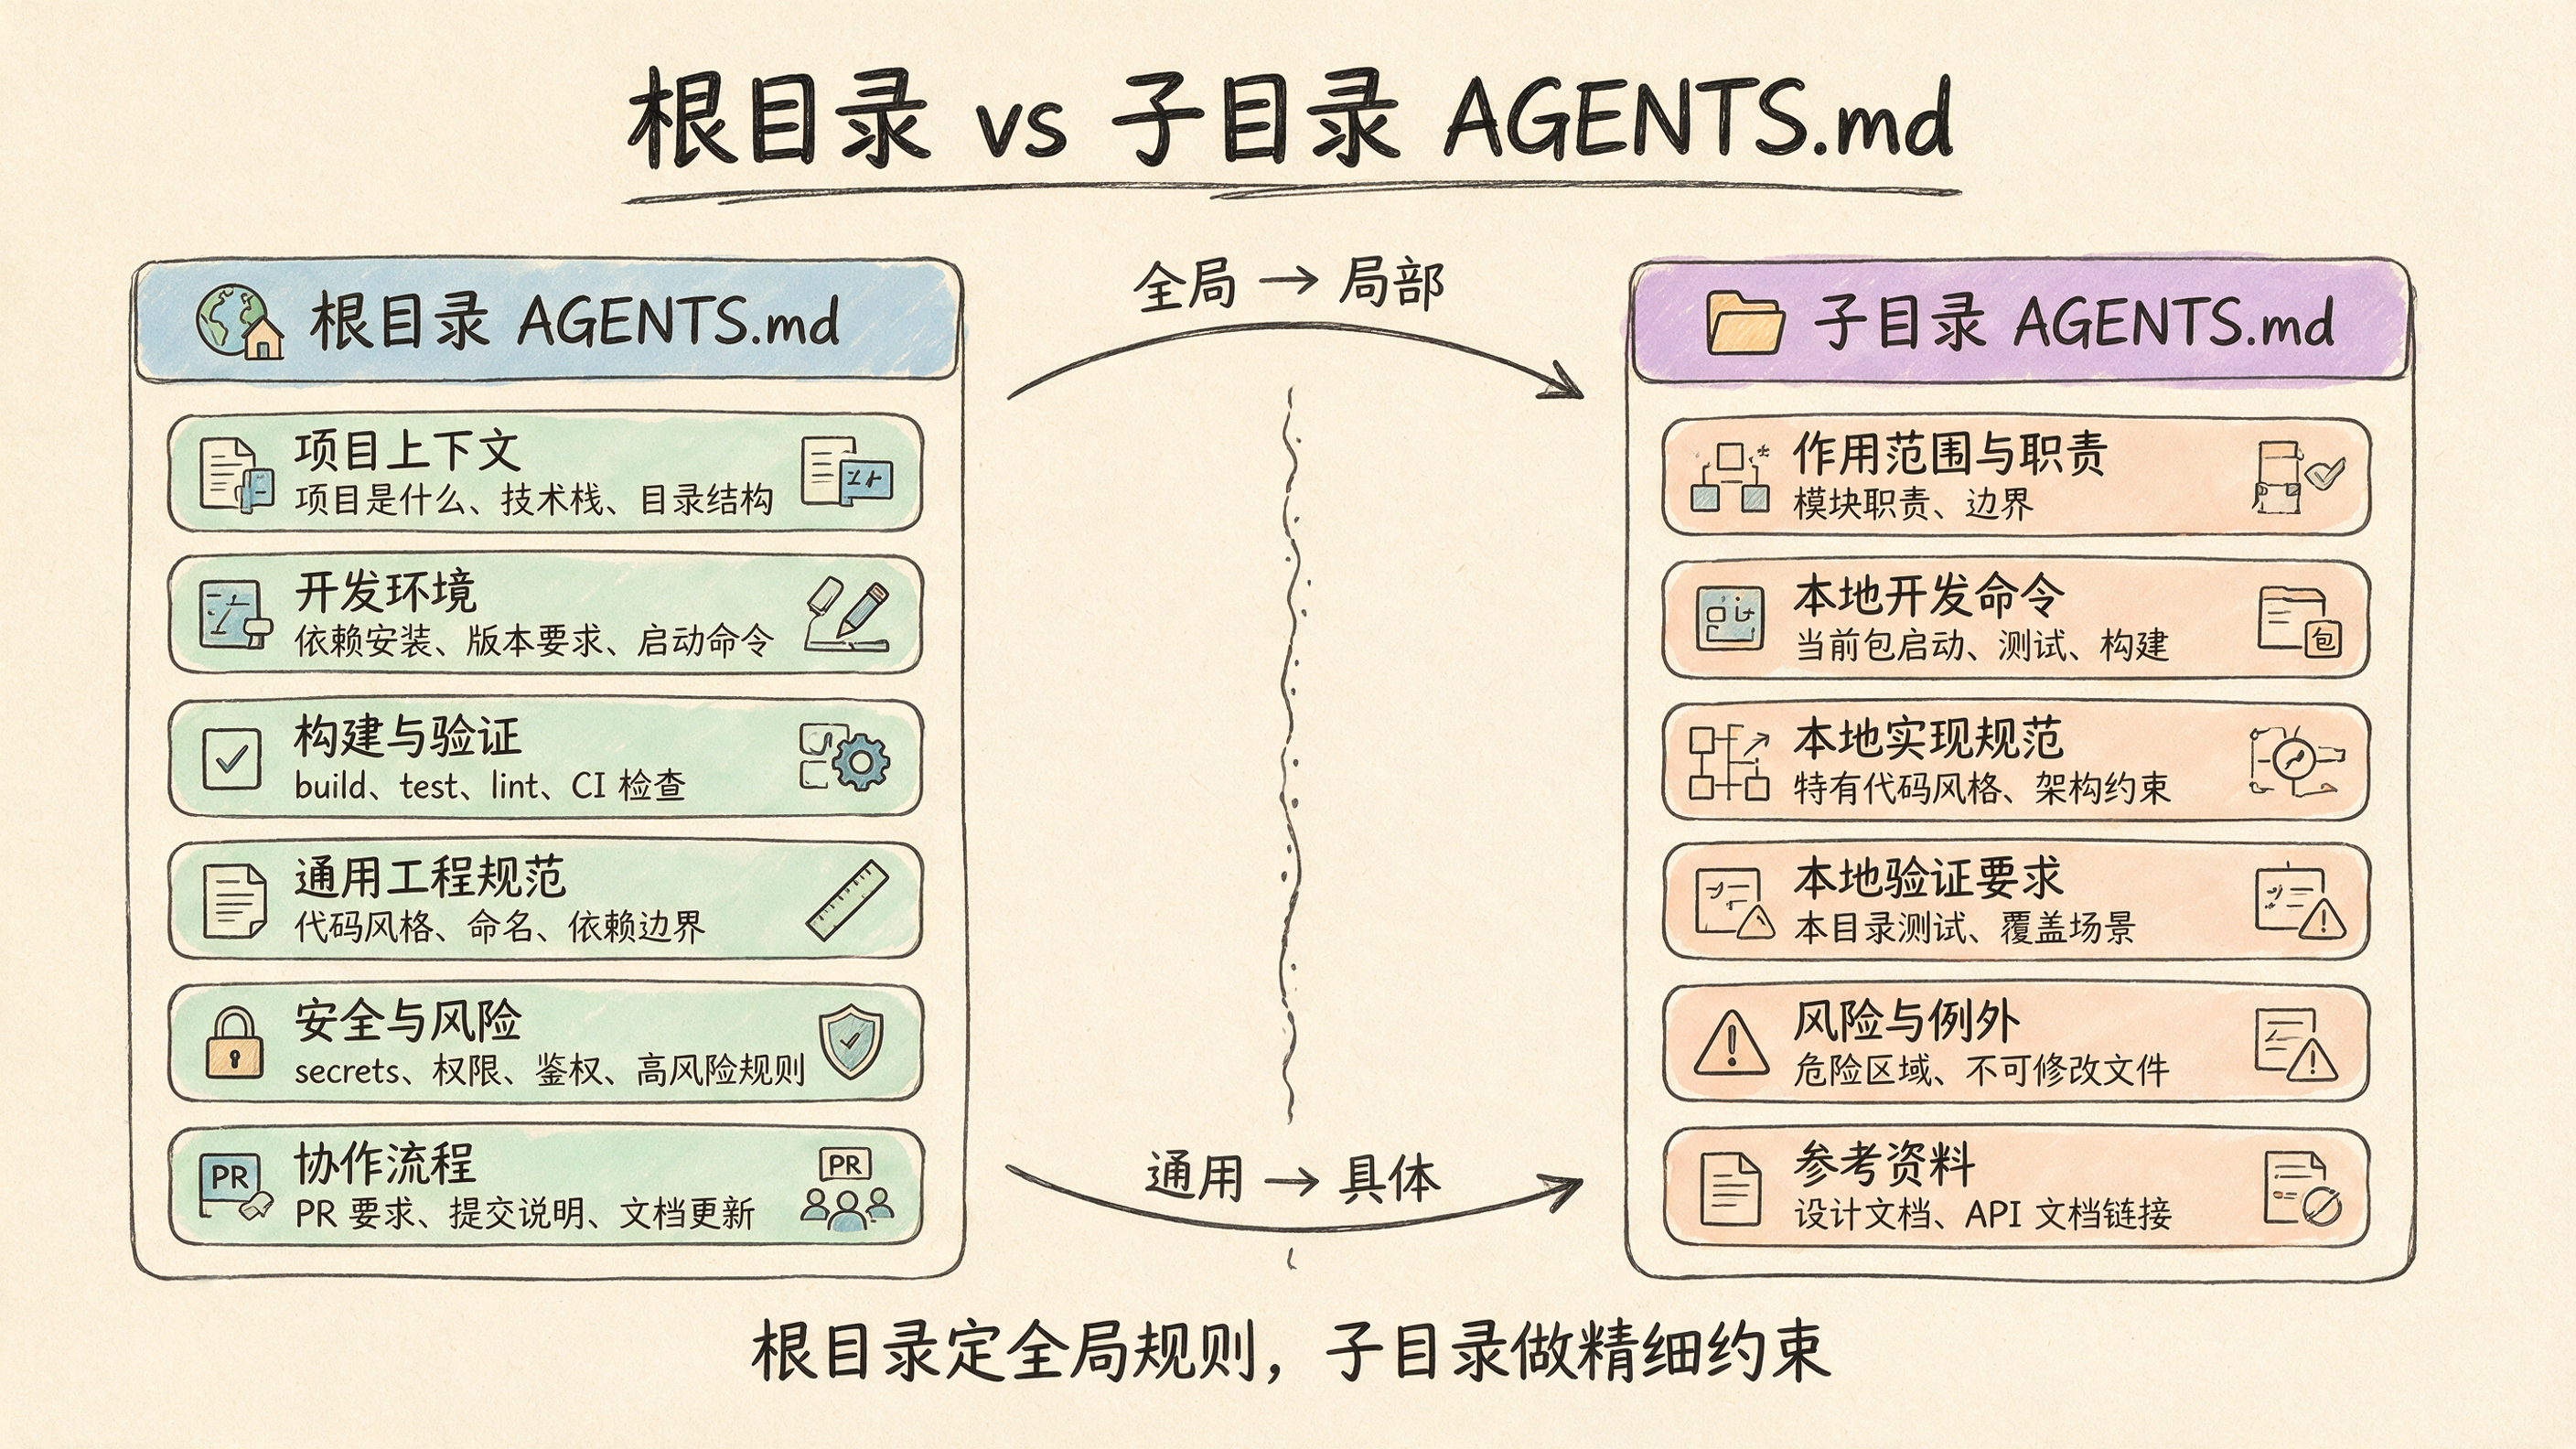
根目录 AGENTS.md
| 分类 | 内容 |
|---|---|
| 项目上下文 | 项目是什么、技术栈、目录结构、主要模块职责 |
| 开发环境 | 依赖安装、运行环境、版本要求、启动命令 |
| 构建与验证 | build、test、lint、typecheck、CI 检查方式 |
| 通用工程规范 | 代码风格、命名、抽象原则、依赖边界、公共 API 约定 |
| 安全与风险 | secrets、权限、鉴权、支付、数据删除、生产配置等高风险规则 |
| 协作流程 | 文档更新、PR 要求、提交说明、变更总结方式 |
子目录 AGENTS.md
| 分类 | 内容 |
|---|---|
| 作用范围与职责 | 当前目录覆盖范围、模块职责、与其他模块的边界 |
| 本地开发命令 | 当前 app/package/service 的启动、测试、构建、生成代码命令 |
| 本地实现规范 | 本模块特有的代码风格、架构约束、依赖规则、领域规则 |
| 本地验证要求 | 修改此目录后应跑哪些测试、重点覆盖哪些场景 |
| 风险与例外 | 当前模块的危险区域、不能随意修改的文件、兼容性要求 |
| 参考资料 | 指向更详细的设计文档、API 文档、流程文档 |
第5章:Agents.md 如何落地:生成、修改、迭代三步走
Agents.md 不应该被当成一次性写完的提示词文件。
更准确地说,它是 Agent 的行为配置文件,也是团队沉淀 AI 工作方式的入口。
在实际落地中,我更推荐用一个简单但有效的方法:
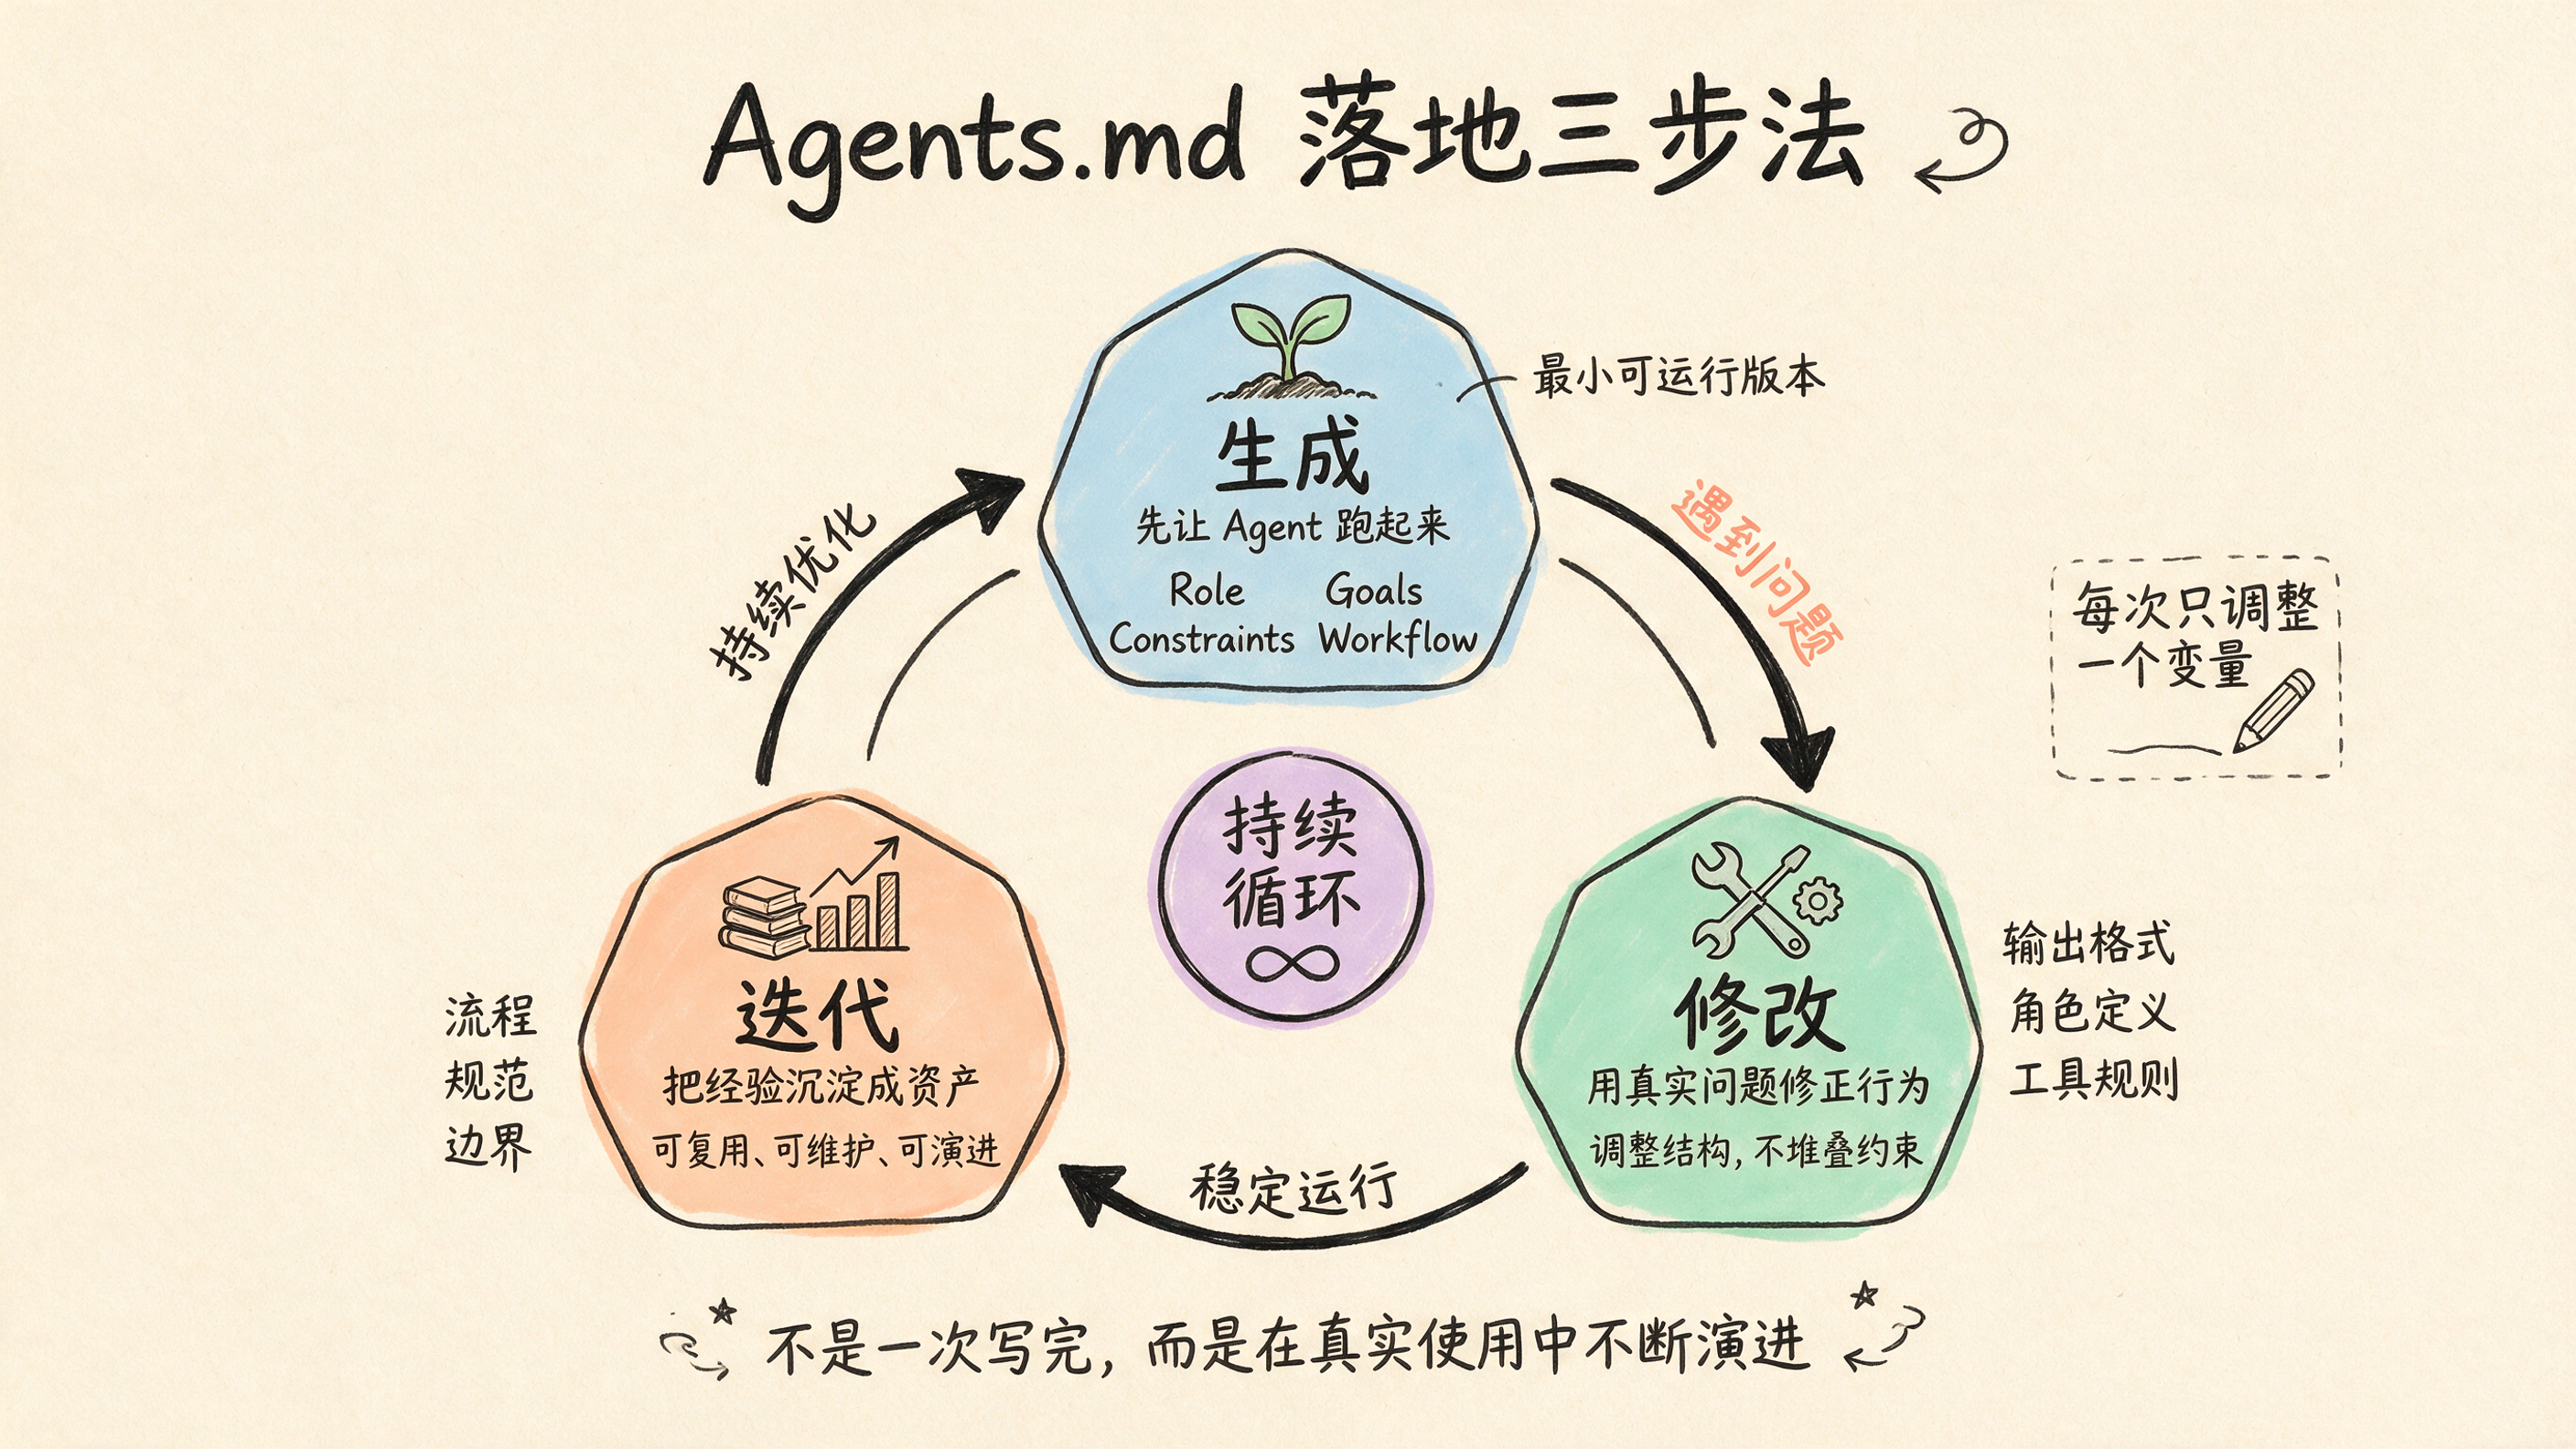
生成 → 修改 → 迭代
这不是线性流程,而是一个持续循环。
5.1 生成:先让 Agent 跑起来
第一版 Agents.md 不需要复杂,重点是建立一个最小可运行版本。
这个阶段的目标不是“写得完美”,而是验证 Agent 是否能完成核心任务。
一个初版通常只需要包含几类信息:
# Role
你是一个资深数据分析助手。

# Goals
帮助用户分析业务数据,并输出可执行的洞察。

# Constraints
- 不编造数据
- 输出结构清晰
- 结论需要有依据

# Workflow
1. 理解用户问题
2. 分析相关数据
3. 输出结论和建议
第一版要尽量克制。
不要一开始就把所有规则、边界、异常情况全部写进去。
内容越复杂,后续越难判断问题到底出在哪里。
这个阶段最重要的是回答三个问题:
- Agent 是否理解自己的角色?
- 输出是否基本稳定?
- 用户是否愿意继续使用?
只要这三个问题能得到验证,第一版就已经完成了它的使命。
5.2 修改:用真实问题修正行为
当 Agent 进入真实使用场景后,一定会出现问题。
比如:
- 输出格式不稳定
- 回答重点偏移
- 任务理解错误
- 工具调用不符合预期
- 长上下文下行为漂移
这些问题不是失败,而是优化 Agents.md 的输入信号。
但修改时要避免一个常见错误:
不断追加“不要这样、必须那样、再次强调”。
这样很容易让 Agents.md 变成规则堆叠,最后越来越难维护。
更好的方式是:
优先调整结构,而不是堆叠约束。
例如,与其这样写:
输出要专业、简洁、有洞察,不能太长,也不能太泛。不如改成:
# Output Format

## Summary
用一句话给出核心结论。

## Key Insights
列出 2-3 个关键发现。

## Recommendations
给出下一步建议。
结构化的要求通常比抽象描述更稳定。
因为模型更容易跟随明确格式,而不是理解模糊风格。
同时,每次修改最好只调整一个变量。
比如这次只改输出格式,下次只改角色定义,再下次只改工具调用规则。
这样才能知道:
到底是哪次修改带来了效果变化。
5.3 迭代:把经验沉淀成资产
当 Agent 能稳定完成任务后,Agents.md 的价值会进一步放大。
它不再只是一个提示词文件,而是团队经验的沉淀载体。
随着使用增加,团队可以逐步把这些内容沉淀进去:
- 常见任务流程
- 标准输出格式
- 失败案例处理方式
- 工具调用规则
- 领域术语和业务约定
- 不同场景下的行为边界
这时,Agents.md 会从“让模型听话”,变成“让团队的 AI 工作方式可复用”。
也正是在这个阶段,团队需要避免另一个误区:
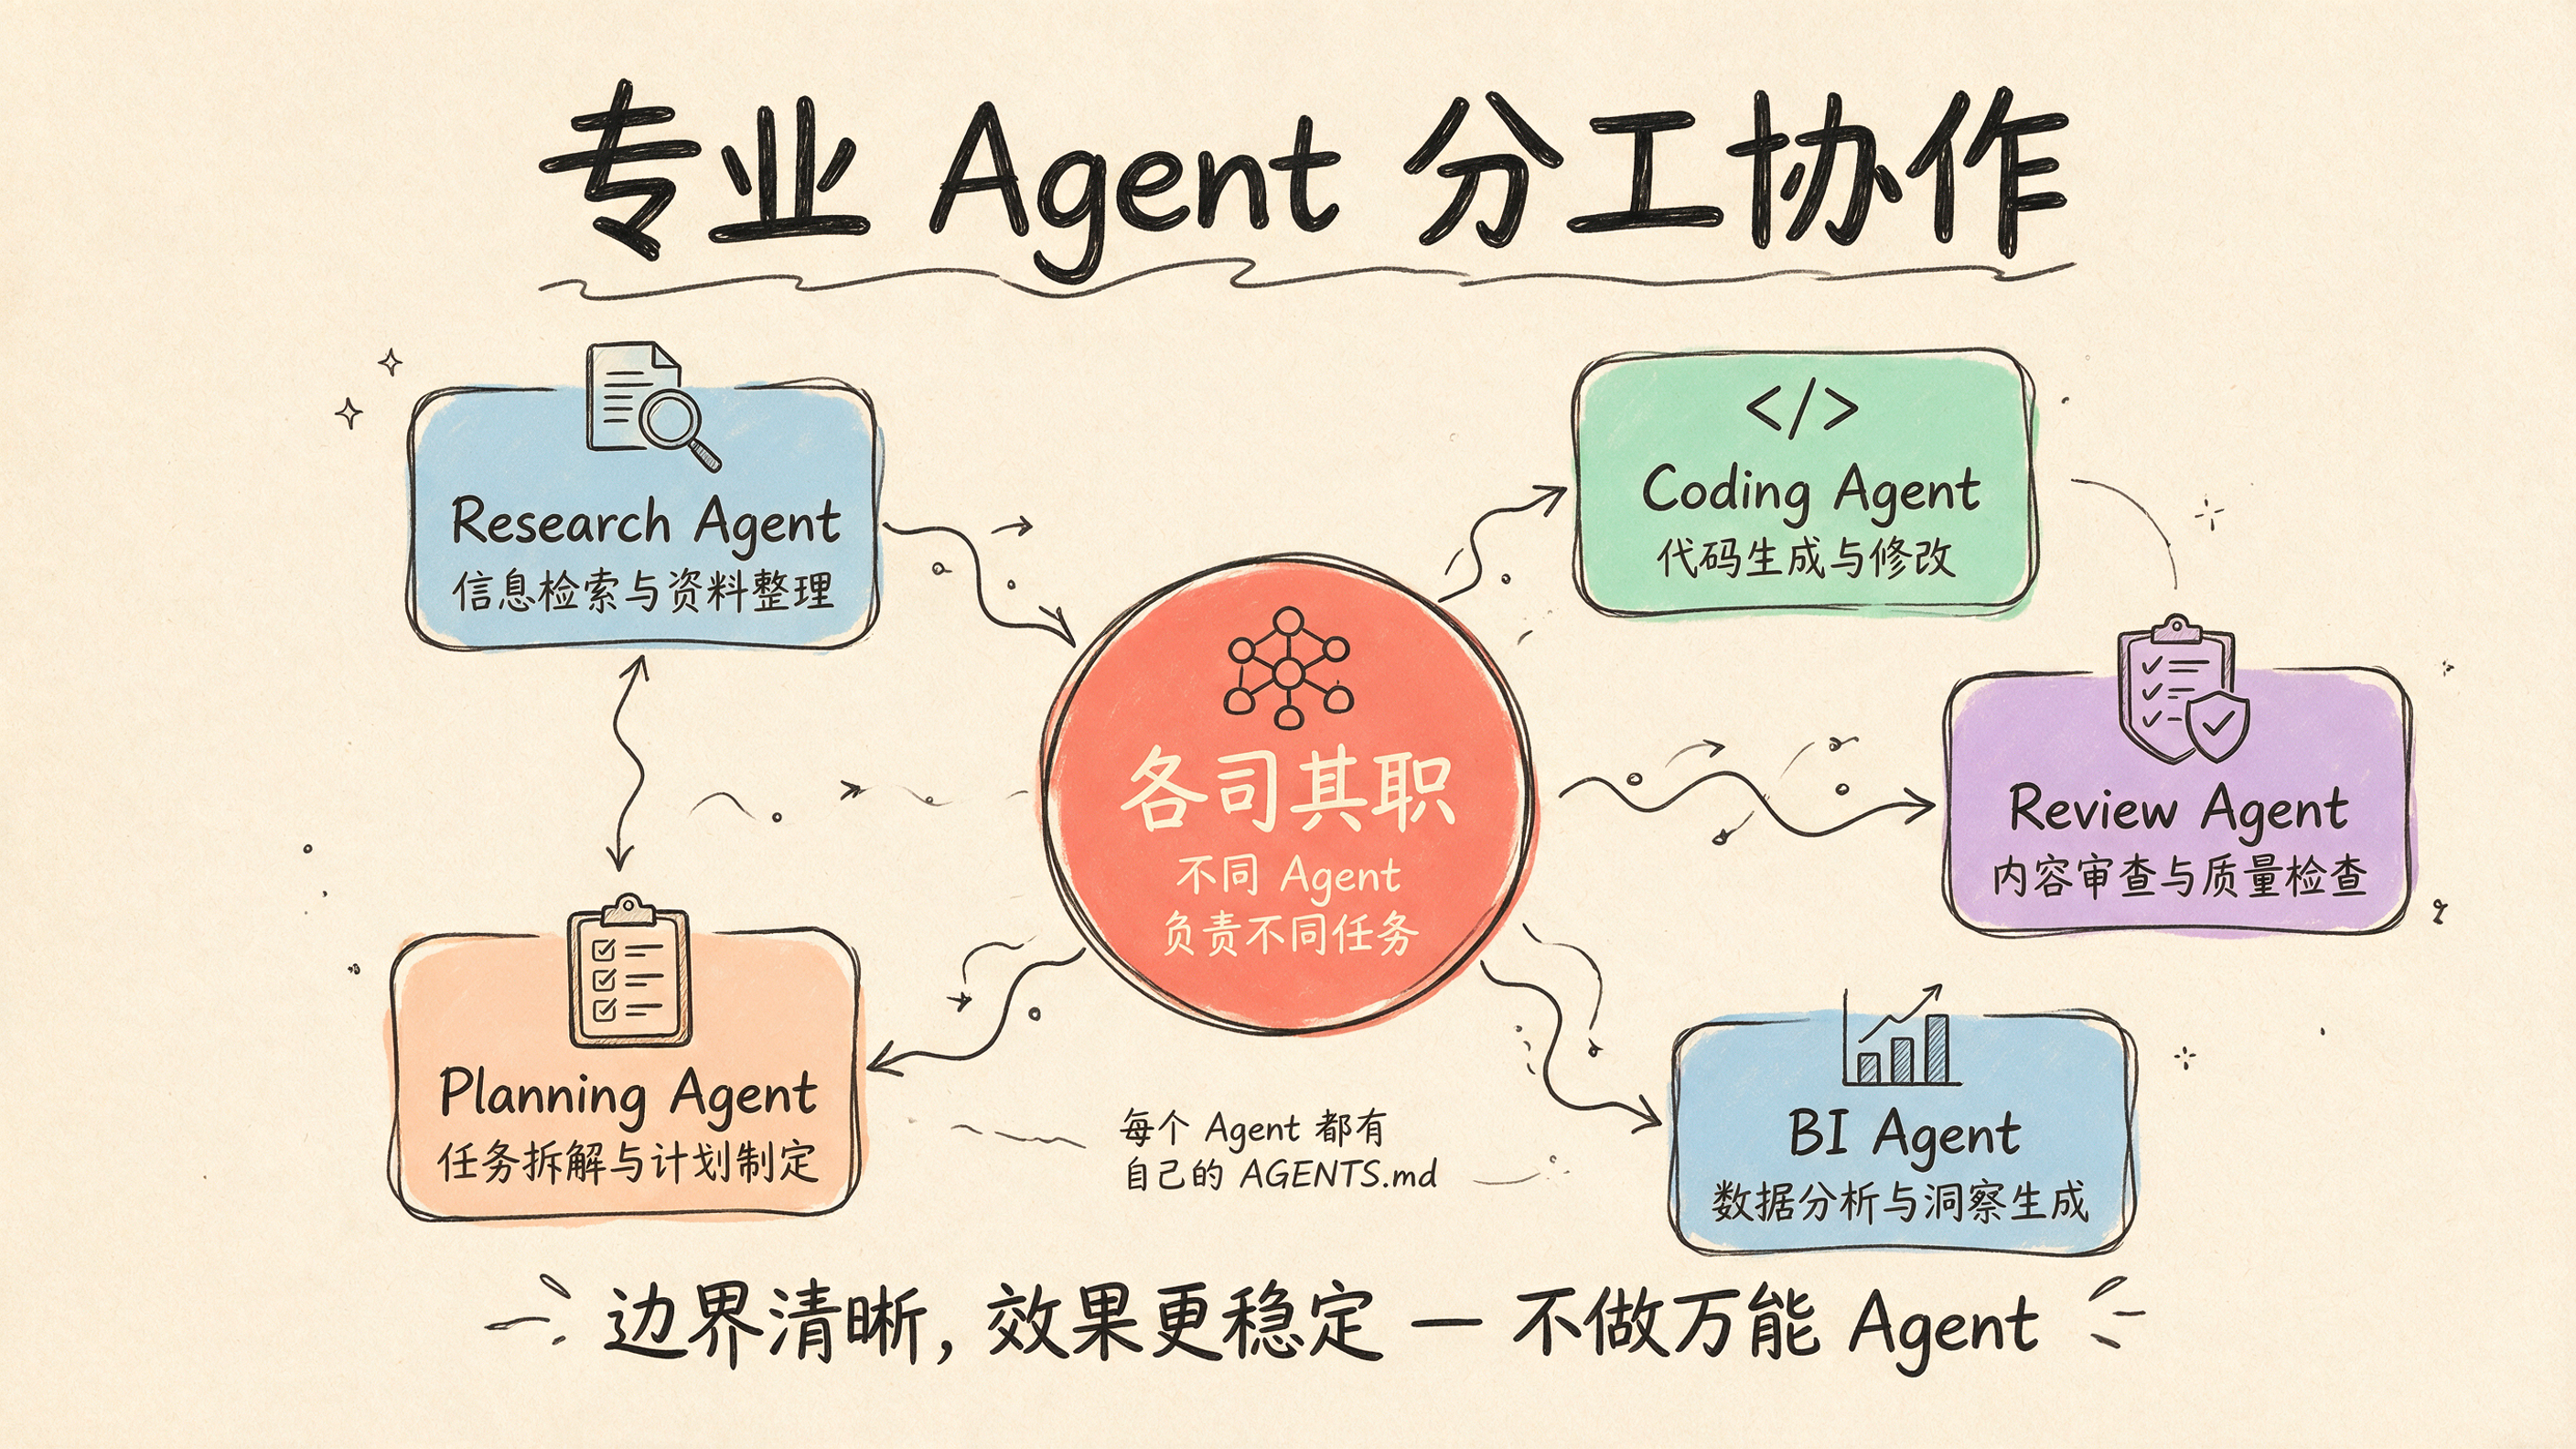
不要试图打造一个万能 Agent。
更合理的方式是让不同 Agent 负责不同任务。
例如:
| Agent | 主要职责 |
|---|---|
| Research Agent | 信息检索与资料整理 |
| Coding Agent | 代码生成与修改 |
| Review Agent | 内容审查与质量检查 |
| Planning Agent | 任务拆解与计划制定 |
| BI Agent | 数据分析与洞察生成 |
每个 Agent 都有自己的 Agents.md,边界更清晰,效果也更稳定。
5.4 把 Agents.md 当成代码管理
真正落地之后,Agents.md 不应该只被当作文档维护。
它更像代码。
既然是代码,就应该有:
- 版本管理
- Code Review
- 测试样例
- 效果评估
- 灰度发布
- 回滚机制
很多 Agent 不稳定,并不是因为模型能力不够,而是因为提示词和行为配置缺少工程化管理。
最终,Agents.md 的价值不在于写出一段完美 Prompt,而在于持续沉淀一套可复用、可维护、可演进的 Agent 行为规范。
一句话总结:
Agents.md 的落地,不是一次写完,而是在真实使用中不断生成、修改、迭代。
茶喝完了,该聊的也聊得差不多了,工作再忙,先把手里那杯喝完再说。
老苏的茶馆不打烊,我们下次再来。
6、参考文件
https://docs.windsurf.com/zh/windsurf/cascade/agents-md
https://redreamality.com/cn/blog/claude-md-agents-md-deep-dive
https://github.com/agentsmd/agents.md
https://www.runoob.com/claude-code/claude-code-claudemd.html